머신러닝 서비스를 운영하려면 모델 성능 외에도 피처 조회, 모델 버전, 배포와 장애 대응을 관리해야 한다. 『Machine Learning Platform Engineering』의 1장은 플랫폼 구성 요소를, 2장은 데이터 수집부터 유지보수까지의 반복 과정을 다룬다.
1장. 머신러닝 플랫폼
1.1 MLOps
MLOps는 머신러닝 시스템의 개발·검증·배포·운영·개선을 위한 실무 체계다. 코드, 데이터, 피처, 모델과 실행 환경을 함께 관리한다.
머신러닝 플랫폼은 이 작업에 필요한 공통 기능을 제공한다. 데이터 과학자는 피처와 실험 결과를 재사용하고, 엔지니어는 배포·모니터링·롤백 절차를 표준화할 수 있다.
실험 단계에서는 데이터와 모델을 바꾸며 성능을 확인한다. 운영 단계에서는 이를 재현 가능한 파이프라인으로 구성하고, 지연 시간·메모리·안정성 등 서비스 조건을 검증한다.
1.2 MLOps vs LLMOps
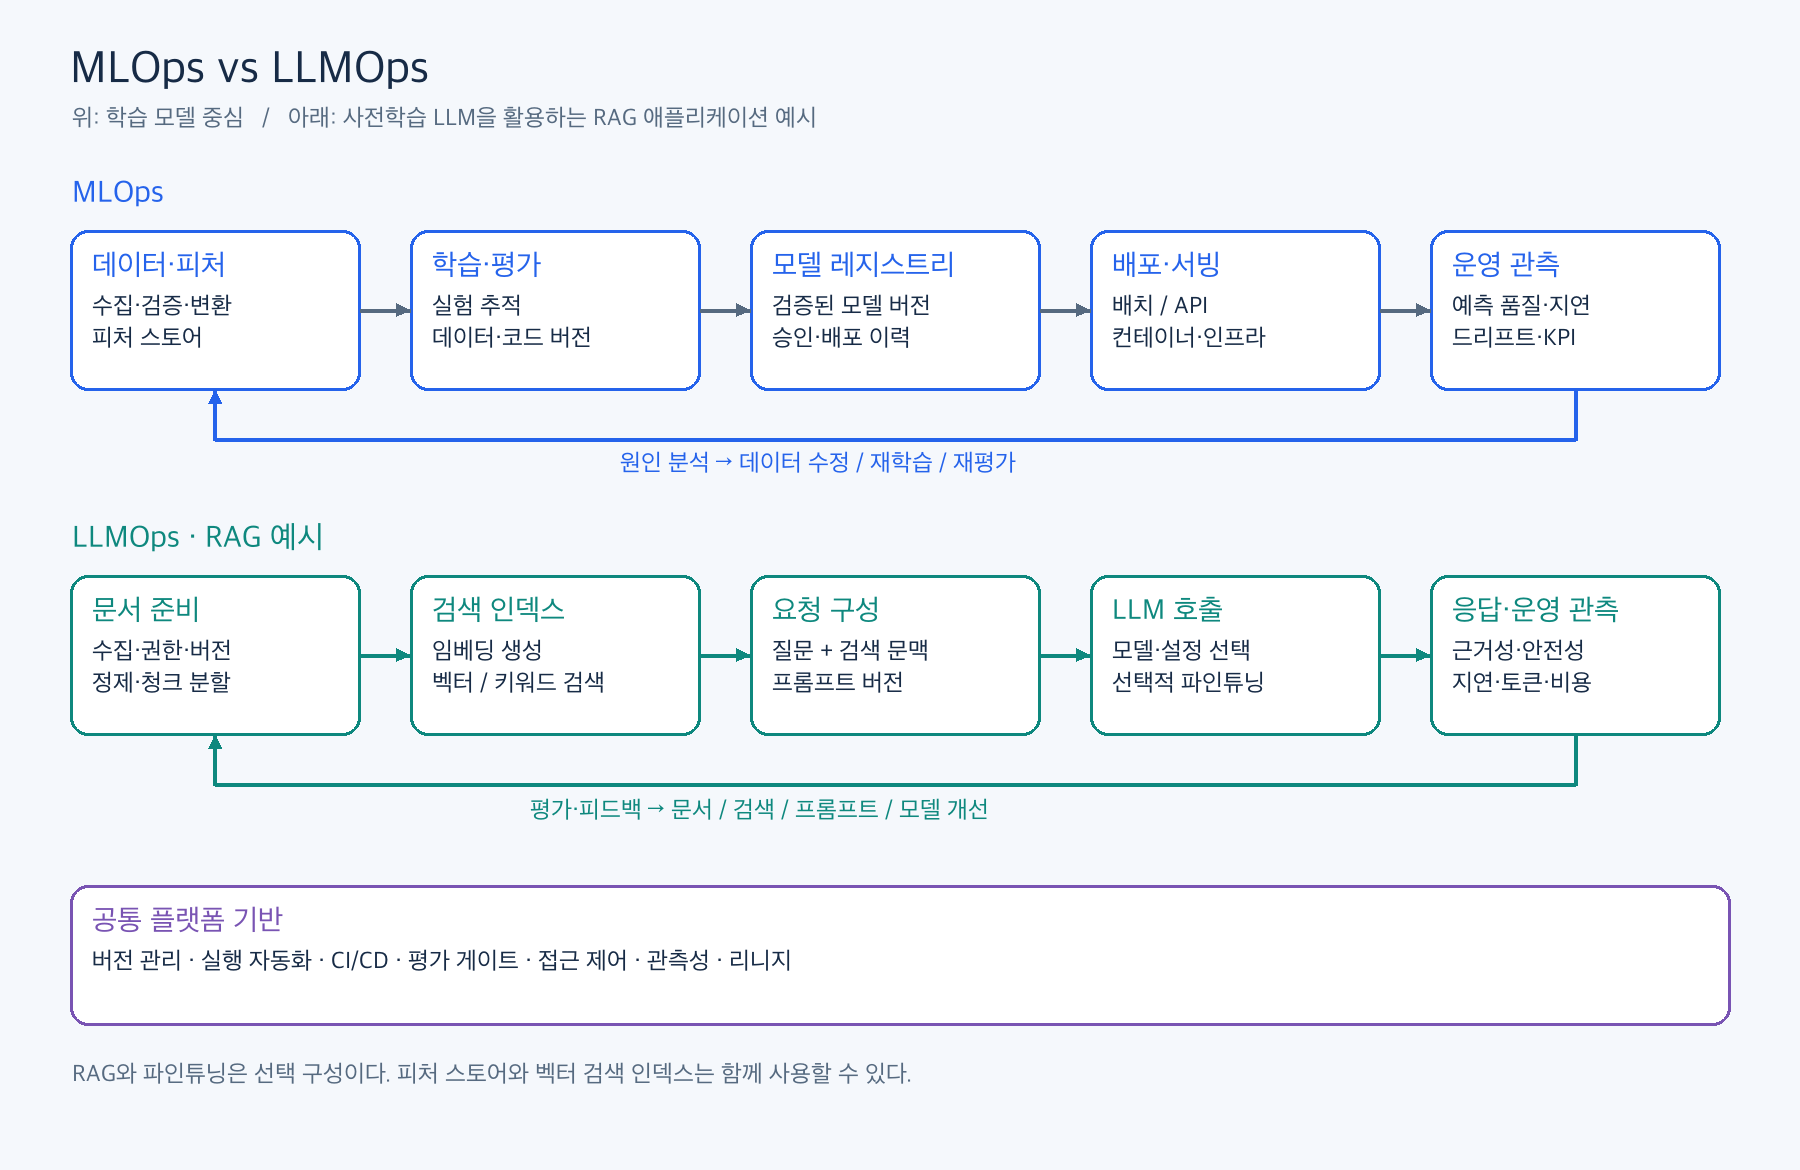
LLMOps는 MLOps의 운영 원칙을 LLM 애플리케이션에 적용하고, 프롬프트·검색 문맥·응답 품질까지 관리하는 체계다. 사전학습 모델을 API로 사용해도 버전 관리와 평가, 운영 관측이 필요하다. Microsoft GenAIOps 설명

그림 1. MLOps와 RAG 기반 LLMOps의 전체 구조
| 항목 | MLOps | LLMOps의 추가 관리 대상 |
|---|---|---|
| 데이터 | 학습·검증 데이터, 라벨, 피처 | 문서, 청크, 임베딩, 검색 인덱스 |
| 버전 | 코드, 데이터셋, 모델 | 프롬프트, 기반 모델, 검색·도구 설정 |
| 평가 | 예측 성능, 집단별 오류 | 답변 관련성·근거성, 검색 품질, 안전성 |
| 운영 지표 | 오류율, 지연, 드리프트 | 토큰 사용량, 비용, 단계별 지연 |
| 개선 방법 | 데이터·피처 수정, 재학습 | 문서·검색·프롬프트 수정, 모델 교체·파인튜닝 |
RAG(Retrieval-Augmented Generation)는 외부 자료를 검색해 생성 모델의 입력 문맥에 추가하는 방식이다.
- 문서 준비: 수집 → 정제·청크 분할 → 임베딩 → 검색 인덱스 갱신
- 사용자 요청: 질문 → 관련 문서 검색 → 문맥·프롬프트 구성 → LLM 호출 → 응답
문서 검색 실패와 근거 없는 답변 생성은 원인이 다르므로 검색 품질과 응답 품질을 나눠 평가한다. 근거성은 답변이 제공된 문맥에 부합하는지를 뜻한다. Microsoft RAG 평가 기준
RAG와 파인튜닝은 선택 구성이다. RAG는 검색 문맥을 추가하고, 파인튜닝은 모델 가중치를 조정한다. 피처 스토어와 벡터 검색 인덱스도 역할이 달라 함께 사용할 수 있다.
1.3 피처 스토어
피처(feature)는 모델의 입력 특성이다. 고객 이탈 예측에서는 최근 30일 구매 횟수, 마지막 접속 후 경과 일수 등을 사용할 수 있다.
피처 스토어는 피처의 정의·메타데이터와 학습·추론용 조회를 관리한다. 여러 모델이 같은 피처를 재사용하고, 계산 기준을 공유하도록 돕는다. 책에서는 Feast를 소개한다. Feast 공식 문서
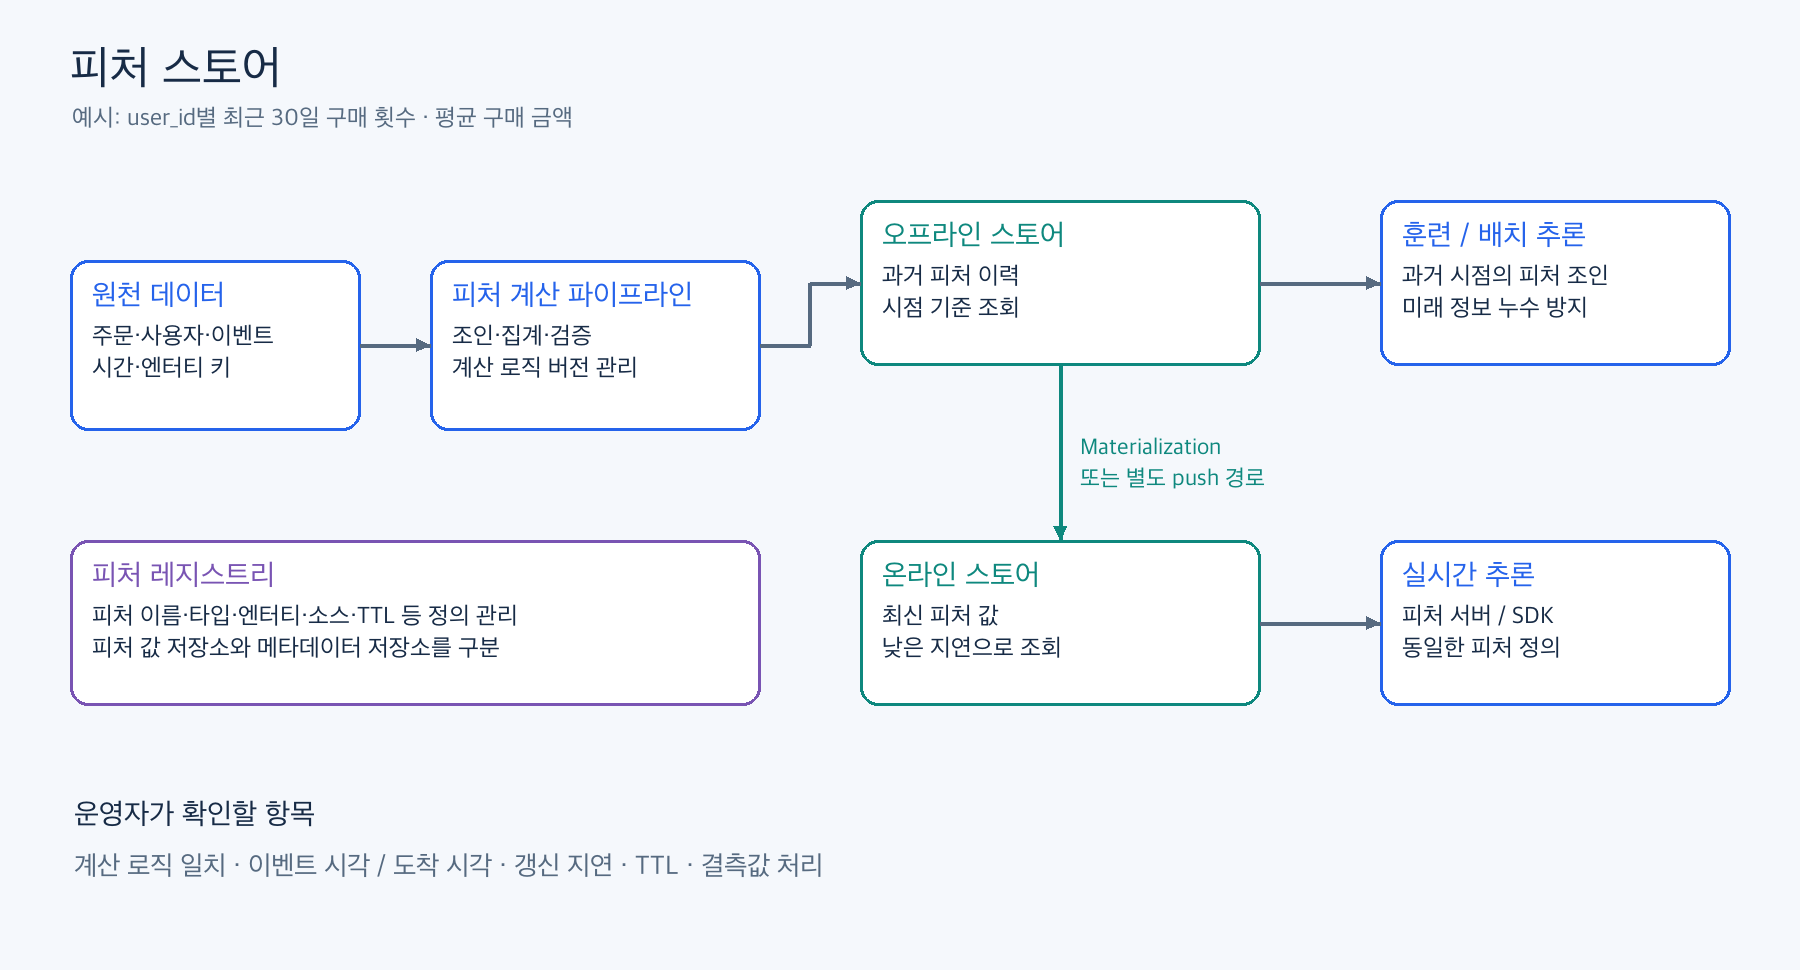
그림 2. 피처 스토어의 오프라인·온라인 조회 경로
주요 구성
| 구성 | 역할 |
|---|---|
| 오프라인 스토어 | 과거 피처 이력을 이용한 학습·배치 추론 |
| 온라인 스토어 | 실시간 추론을 위한 최신 피처의 저지연 조회 |
| 피처 레지스트리 | 피처 이름, 타입, 엔터티 키, 소스 등의 정의 관리 |
| 피처 서버·SDK | 애플리케이션의 피처 조회 인터페이스 |
학습과 서빙에서는 같은 피처 정의와 관리 체계를 사용하되, 목적에 따라 저장소를 분리할 수 있다. Feast는 과거 피처 조회와 온라인 조회를 제공한다. 조인·집계 같은 상류 변환 작업은 별도 데이터 파이프라인에서 수행할 수 있다. Feast 피처 조회, Feast 역할과 범위
학습·서빙 불일치
학습·서빙 불일치(training-serving skew)는 학습과 추론에서 피처 계산·처리 방식 등이 달라지는 문제다. 학습에서는 최근 30일, 운영에서는 달력 기준 한 달의 구매 횟수를 사용하면 같은 이름의 피처라도 값이 달라질 수 있다.
피처 정의와 계산 로직을 공유해 위험을 줄이고, 갱신 지연·시간대·결측값 처리도 점검해야 한다.
시점 기준 정합성
시점 기준 정합성(point-in-time correctness)은 예측 기준 시각에 맞는 피처를 사용하는 조건이다. 9월 1일의 이탈 예측에 9월 10일의 구매를 포함하면 미래 정보 누수가 발생한다. Feast의 point-in-time join은 기준 시각에 맞는 과거 피처를 결합한다. Feast 시점 기준 조인
과거 운영 조건을 재현할 때에는 이벤트 발생 시각과 시스템 도착 시각의 차이도 고려해야 한다.
1.4 모델 레지스트리
모델 레지스트리는 모델의 버전과 생성 이력, 메타데이터를 관리하는 체계다. 예를 들어 churn-model의 v6과 v7을 구분하고, 각 버전의 원본 실험과 검증 상태를 확인한다. MLflow Model Registry
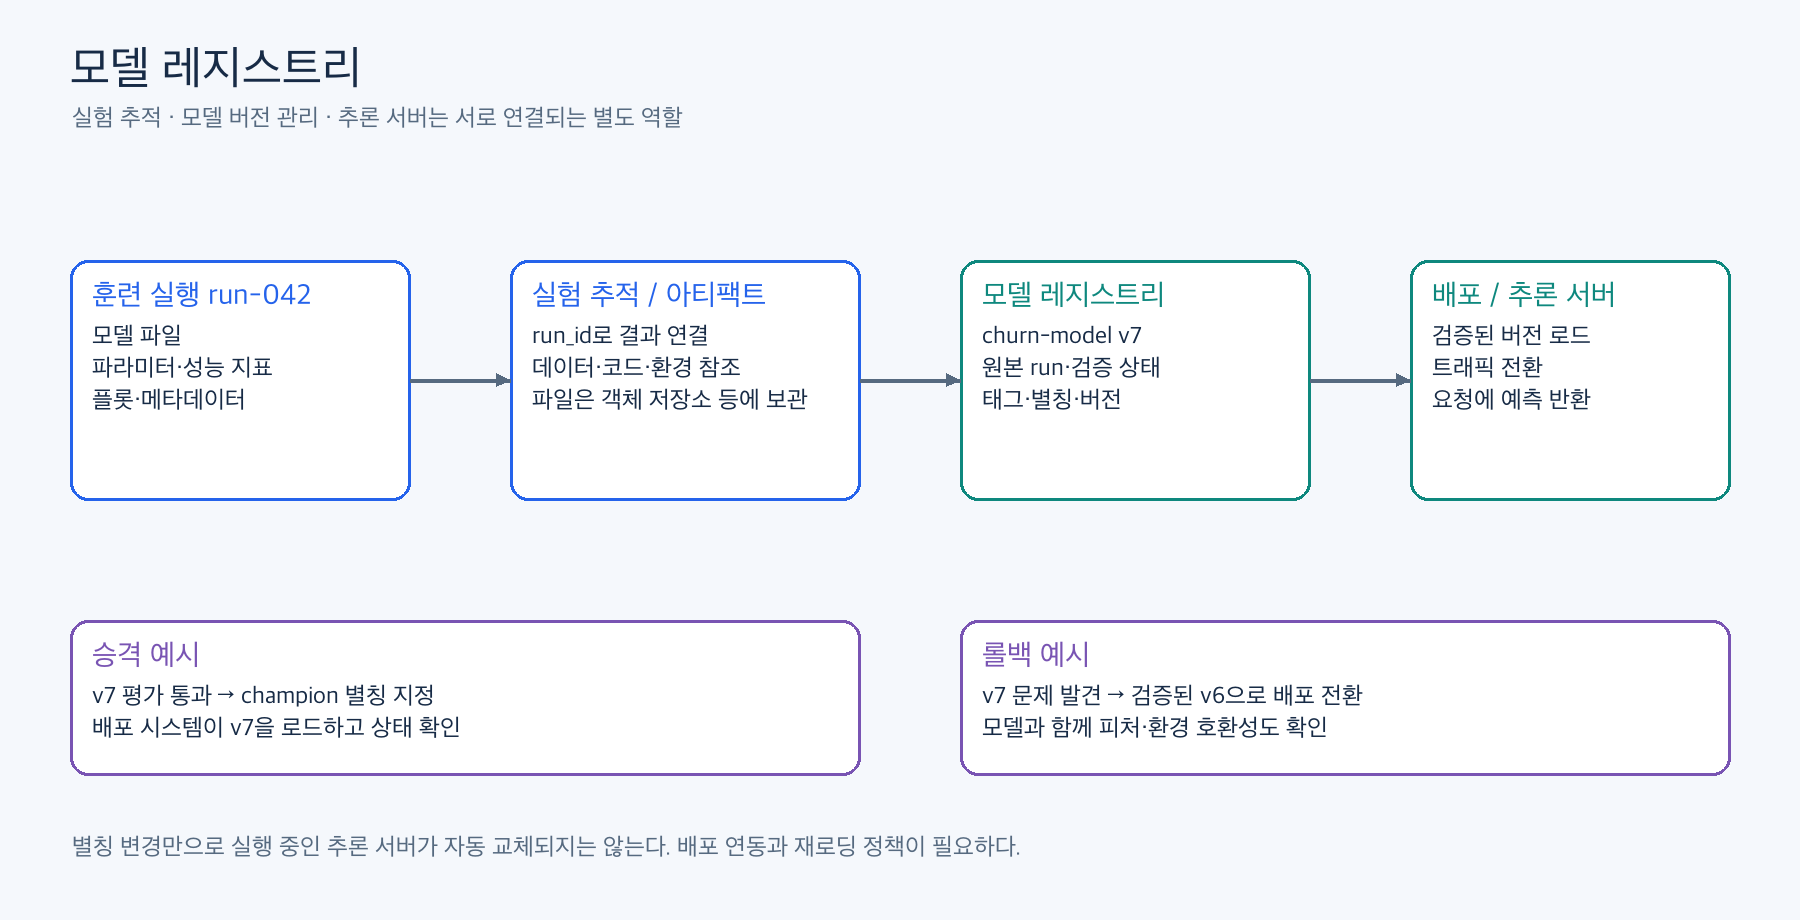
그림 3. 훈련 결과부터 모델 등록·배포까지의 흐름
훈련 결과와 실험 추적
| 기록 대상 | 예시 |
|---|---|
| 모델 | 가중치, 전처리기, 추론 패키지 |
| 파라미터 | 학습률, 트리 깊이, 배치 크기 |
| 지표·분석 결과 | F1, AUC, 손실 곡선, 혼동 행렬 |
| 메타데이터 | 데이터 버전, Git commit, 실행 환경·시각 |
MLflow의 실험 추적 기능은 실행별 조건과 결과를 기록하고, 모델 레지스트리는 등록 모델의 버전과 이력을 관리한다. 모델 파일과 플롯 등의 아티팩트는 별도 저장소와 연결할 수 있다. MLflow 실험 추적
피처 레지스트리는 입력 피처의 정의, 모델 레지스트리는 학습한 모델의 버전과 이력을 관리한다.
모델 승격·롤백
운영 반영 절차는 모델 등록 → 평가·승인 → 배포·점진 전환 → 상태 확인으로 정리할 수 있다. 문제가 생기면 검증된 이전 모델과 호환 환경으로 되돌린다.
MLflow의 고정 Model Stages는 2.9.0부터 deprecated 상태이며, 공식 문서는 태그·별칭·환경 구분을 활용한 관리를 안내한다. champion 같은 별칭으로 운영 대상 버전을 참조할 수 있다. MLflow 워크플로
별칭 변경 후에는 추론 서버의 재로딩이나 배포 교체가 필요하다. 버전 선택과 실제 트래픽 전환을 연결해야 한다.
1.5 플랫폼 구성 요소
| 구성 요소 | 역할 |
|---|---|
| 파이프라인 오케스트레이터 | 데이터 준비·학습·평가의 순서와 의존성 관리 |
| 피처 스토어 | 피처 정의와 학습·추론용 조회 |
| 실험 추적 도구 | 실행 조건과 결과 기록·비교 |
| 모델 레지스트리 | 모델 버전·생성 이력·검증 상태 관리 |
| 컨테이너 레지스트리 | 실행 이미지를 저장·관리 |
| CI/CD | 변경 검사·빌드·배포 자동화 |
| 서빙·모니터링 | 추론 수행과 서비스·모델 품질 관측 |
Kubeflow Pipelines는 컴포넌트와 입출력으로 작업을 연결한다. 팀은 실행 결과와 실패 지점, 산출물을 추적할 수 있도록 파이프라인을 구성한다. Kubeflow Pipelines 개요
직접 구축과 관리형 서비스 중에서는 팀의 인력·규모·배포 빈도에 맞는 방식을 선택한다.
2장. MLOps 수명주기와 리니지
2.1 MLOps 수명주기
운영 중에는 데이터와 사용자 행동이 바뀐다. 팀은 운영 결과를 바탕으로 데이터·모델·평가 기준을 다시 검토한다.
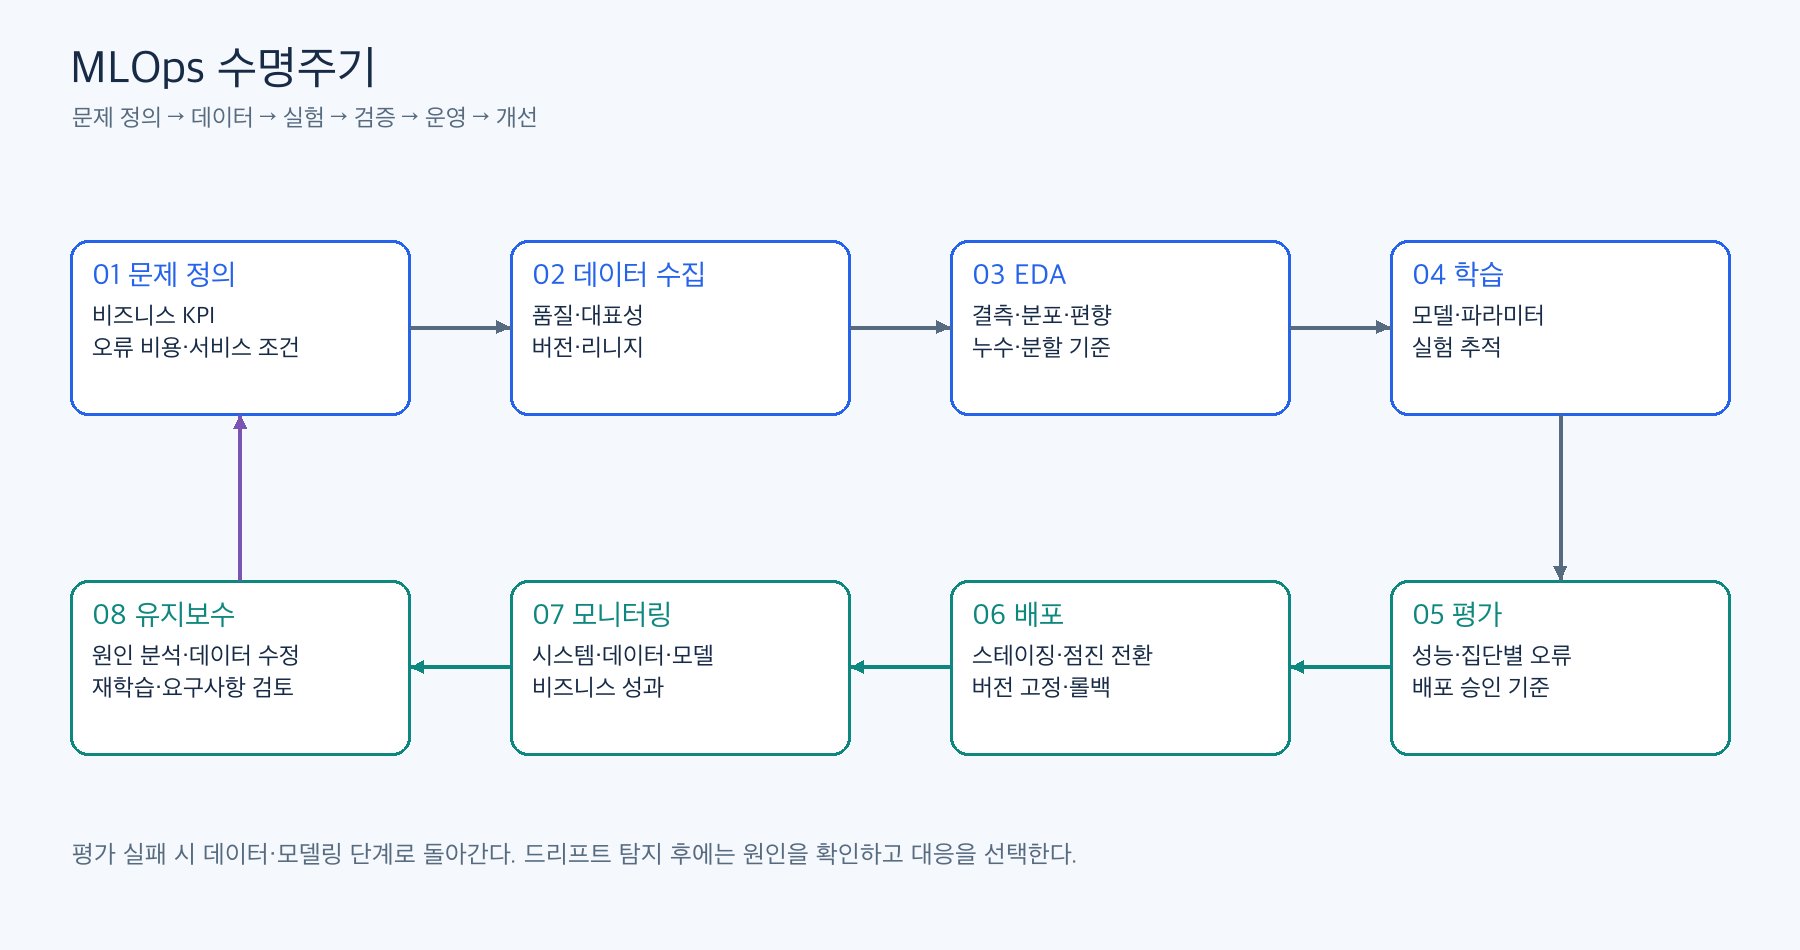
그림 4. 문제 정의부터 유지보수까지의 반복 과정
| 단계 | 주요 확인 사항 | 산출물 |
|---|---|---|
| 문제 정의·설계 | 목표, 오류 비용, KPI, 서비스 조건 | 요구사항, 성공 기준 |
| 데이터 수집 | 품질, 대표성, 편향, 출처 | 데이터 버전, 리니지 |
| EDA | 결측·분포·라벨 품질·누수 | 분석 결과, 분할 전략 |
| 모델링·훈련 | 모델·파라미터·실행 조건 | 코드·설정·환경, 실험 기록 |
| 평가 | 기준 모델 대비 성능, 집단별 오류 | 평가 결과, 승인 근거 |
| 배포 | 호환성, 점진 전환, 롤백 | 모델·이미지 버전, 배포 이력 |
| 모니터링 | 시스템·데이터·모델·사업 성과 | 지표, 로그, 알림 |
| 유지보수 | 원인, 수정 방향, 목표 유효성 | 데이터 수정, 재학습·교체 결정 |
평가 지표는 사업의 오류 비용에 맞춰 선택한다. 모니터링에서도 입력 분포 변화와 실제 예측 성능을 구분해야 한다. 고객 이탈 여부처럼 정답을 나중에 확보하는 서비스에서는 성능 평가에 시차가 생긴다.
2.2 리니지와 데이터 리니지
리니지(lineage)는 산출물의 출처, 처리 과정과 사용 관계를 연결한 이력이다. 운영 모델을 만든 데이터·코드·실행을 추적하고, 원천 오류가 영향을 미친 결과를 찾는 데 사용한다.
데이터 리니지(data lineage)는 데이터의 출처와 이동·변환·파생 관계를 추적한다. OpenLineage는 이를 Dataset, Job, Run으로 표현한다. OpenLineage 객체 모델
| 개념 | 의미 | 예시 |
|---|---|---|
| Dataset | 작업의 입력·출력 데이터 | 원천 주문 스냅샷, 정제 테이블 |
| Job | 정의된 처리 작업 | 중복 제거, 피처 집계 |
| Run | 작업의 특정 실행 | 10월 1일 02시의 정제 실행 |
같은 Job도 입력과 코드 버전이 달라지면 결과가 달라질 수 있으므로, 개별 Run의 입력·출력을 연결해야 한다.
2.3 데이터 리니지 구조
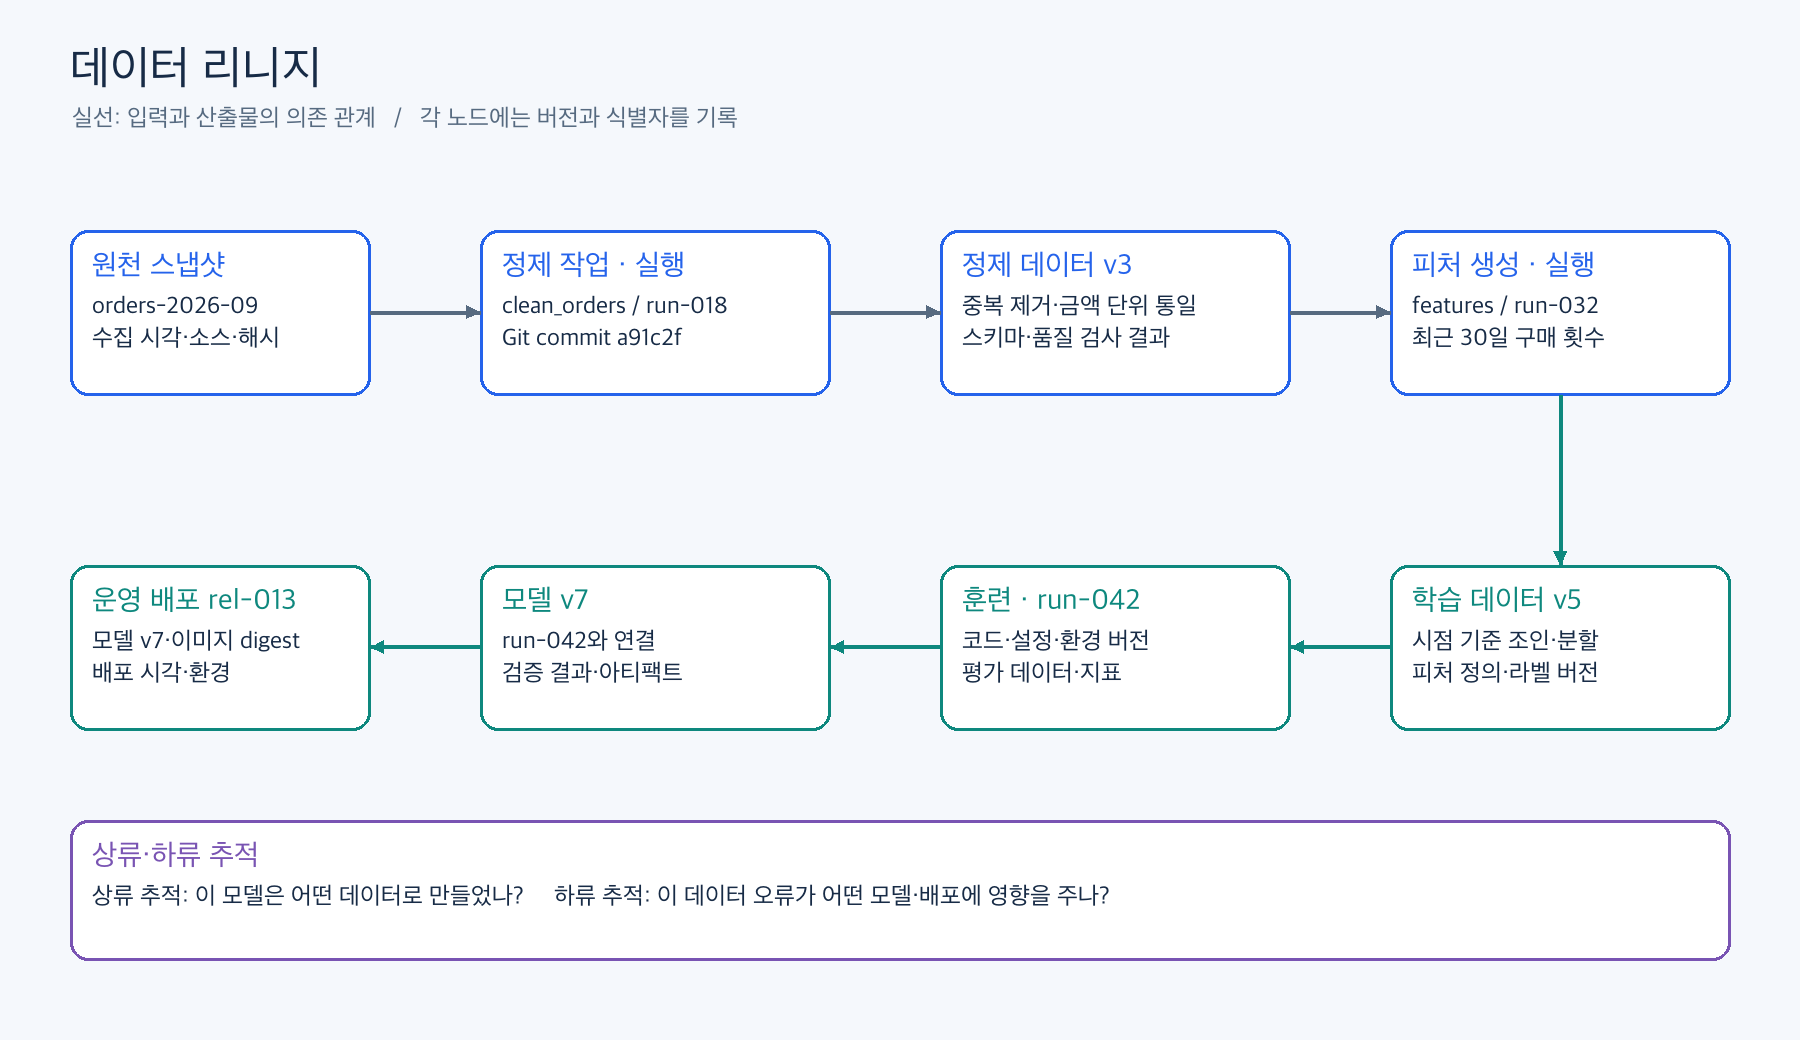
그림 5. 데이터·실행·모델·배포의 연결 관계
- 상류 추적(upstream): 운영 모델에서 원천 데이터로 거슬러 올라가 원인 조사
- 하류 추적(downstream): 오류가 있는 원천에서 파생 데이터·모델·배포로 이동하며 영향 범위 조사
주문 금액의 단위 변환에 오류가 있었다면, 해당 코드와 실행에서 생성한 피처·학습 데이터·모델을 찾고 수정 범위를 정할 수 있다. 의존 관계로 조사 대상을 좁힌 뒤, 데이터와 모델을 재평가해 실제 영향을 확인한다.
2.4 버전 관리와 리니지
| 구분 | 기록 내용 | 예시 |
|---|---|---|
| 버전 관리 | 데이터의 특정 상태 | training-data-v5 |
| 리니지 | 입력·처리·출력의 관계 | orders-v2 → clean-run-018 → training-data-v5 |
| 실행 로그 | 처리 중 발생한 일 | 처리 건수, 경고, 오류 |
| 메타데이터 | 데이터·작업의 속성 | 소유자, 스키마, 시각 |
재현을 위해서는 데이터 버전과 생성 경로를 함께 보존해야 한다. 리니지가 있어도 원본을 덮어썼거나 코드·환경을 복원할 수 없다면 재실행이 어렵다.
리니지는 여러 입력의 조인과 여러 출력의 분기를 포함하는 그래프다. 자료의 “선형적인 과정”이라는 표현은 처리 순서를 추적할 수 있다는 의미로 이해하는 편이 적절하다.
2.5 리니지 기록 항목
| 대상 | 기록 항목 |
|---|---|
| 원천 데이터 | 소스, 수집 목적·시각, 대상 기간, 스냅샷 ID·해시 |
| 정제·변환 | Job·Run ID, 입력·출력 ID, 코드 commit, 설정 |
| 라벨링·증강 | 라벨 스키마, 작업 버전, 검수 결과, 원본 관계 |
| 피처 | 정의, 엔터티 키, 시간 기준, 계산 로직 버전 |
| 학습·평가 | 데이터·분할 버전, 파라미터, 환경, 평가 결과 |
| 모델·배포 | 모델 버전, 아티팩트 ID, 이미지 digest, 배포 이력 |
테이블 수준에서는 orders → customer_features, 열 수준에서는 orders.amount → customer_features.avg_order_amount_30d까지 추적할 수 있다. 필요한 상세도에 맞춰 수집 범위를 정한다.
재현성은 난수 시드 외에도 데이터·코드·설정·라이브러리·하드웨어 조건의 영향을 받는다.
2.6 LLMOps 리니지
RAG 응답의 원인을 조사하려면 다음 정보를 요청·응답과 연결한다.
- 원본 문서·청크 ID와 버전
- 임베딩 모델, 검색 인덱스와 검색·재정렬 설정
- 실제 검색 문서, 프롬프트 버전, LLM 식별자·생성 설정
- 요청 trace ID, 응답, 평가·피드백
이 기록으로 문서 갱신 누락, 검색 실패, 프롬프트 문제를 구분할 수 있다. 운영 기록에는 접근 권한과 보존 정책을 적용한다.
2.7 DevOps·MLOps와 CI/CD/CT
DevOps와 MLOps는 자동화·테스트·배포 원칙을 공유한다. MLOps에서는 데이터와 모델의 통계적 특성까지 관리한다. 코드 변경 없이도 입력 데이터가 달라져 모델 성능이 떨어질 수 있기 때문이다.
| 구분 | 역할 |
|---|---|
| CI · Continuous Integration | 코드·파이프라인 변경 통합과 검사 |
| CD · Continuous Delivery/Deployment | 검증 결과의 배포 절차 연결 |
| CT · Continuous Training | 새 데이터·조건에 따른 학습·평가 반복 |
입력 변화만으로 고정된 모델의 가중치가 바뀌지는 않는다. 재학습·검증을 거쳐 새 버전을 만든다. 드리프트 탐지 후에는 원인을 조사하고, 재학습한 모델도 평가를 통과한 뒤 배포해야 한다. Google Cloud MLOps 자동화
2.8 MLOps 성숙도와 조직 역할
Google Cloud는 자동화 범위에 따라 MLOps 성숙도를 구분한다.
| 수준 | 자동화 범위 |
|---|---|
| Level 0 | 수작업 중심의 개발·학습·배포 |
| Level 1 | 학습 파이프라인 자동화와 CT |
| Level 2 | ML 파이프라인 변경의 테스트·빌드·배포를 위한 CI/CD |
모델 파일의 배포와 학습 파이프라인, 파이프라인 변경 과정의 자동화를 구분하는 것이 핵심이다. Google Cloud MLOps 성숙도
팀은 도구와 함께 책임도 정해야 한다. 데이터 오류 조사, 모델 승인, 배포·롤백 담당자를 명확히 해 운영 문제에 대응한다.
핵심 개념 요약
| 개념 | 관리 대상 |
|---|---|
| MLOps | 머신러닝 시스템의 개발·배포·운영·개선 |
| LLMOps | LLM 서비스와 문서·검색·프롬프트·응답 품질 |
| 피처 스토어 | 모델 입력 피처의 정의와 조회 |
| 모델 레지스트리 | 모델 버전과 생성·검증 이력 |
| 데이터 리니지 | 데이터의 출처와 변환·사용 관계 |
이 요소를 연결하면 운영 모델의 생성 과정을 추적하고, 데이터 오류의 영향 범위를 찾아 수정·평가·재배포할 수 있다.
참고 자료
- 가시다님 머신러닝 플랫폼 엔지니어링 스터디 자료
- Manning: 1장 공개 개요
- Manning: 2장 공개 개요
- Feast 공식 문서
- MLflow Model Registry
- OpenLineage 객체 모델
- Google Cloud: MLOps 자동화와 성숙도
그림은 개념 설명용이며, 버전·식별자는 가상 예시다.